Produit personnel. Je l'ai construit parce qu'aucune application existante ne correspondait à ma façon d'apprendre
WeSpeak
Une application Web progressive pour retenir les mots anglais croisés au quotidien, grâce à la répétition espacée et à des exemples générés par l'IA.
- Rôle
- Créateur. Produit, schéma SQL, interface, chaîne d'IA, déploiement
- Période
- juin 2026 – aujourd'hui
- Statut
- En ligne, inscriptions ouvertes
- Technologies
- React
- Vite
- TypeScript
- Supabase (Auth + PostgreSQL)
- Node / Express
- GitHub Actions
- Vercel
Liens
trywespeak.com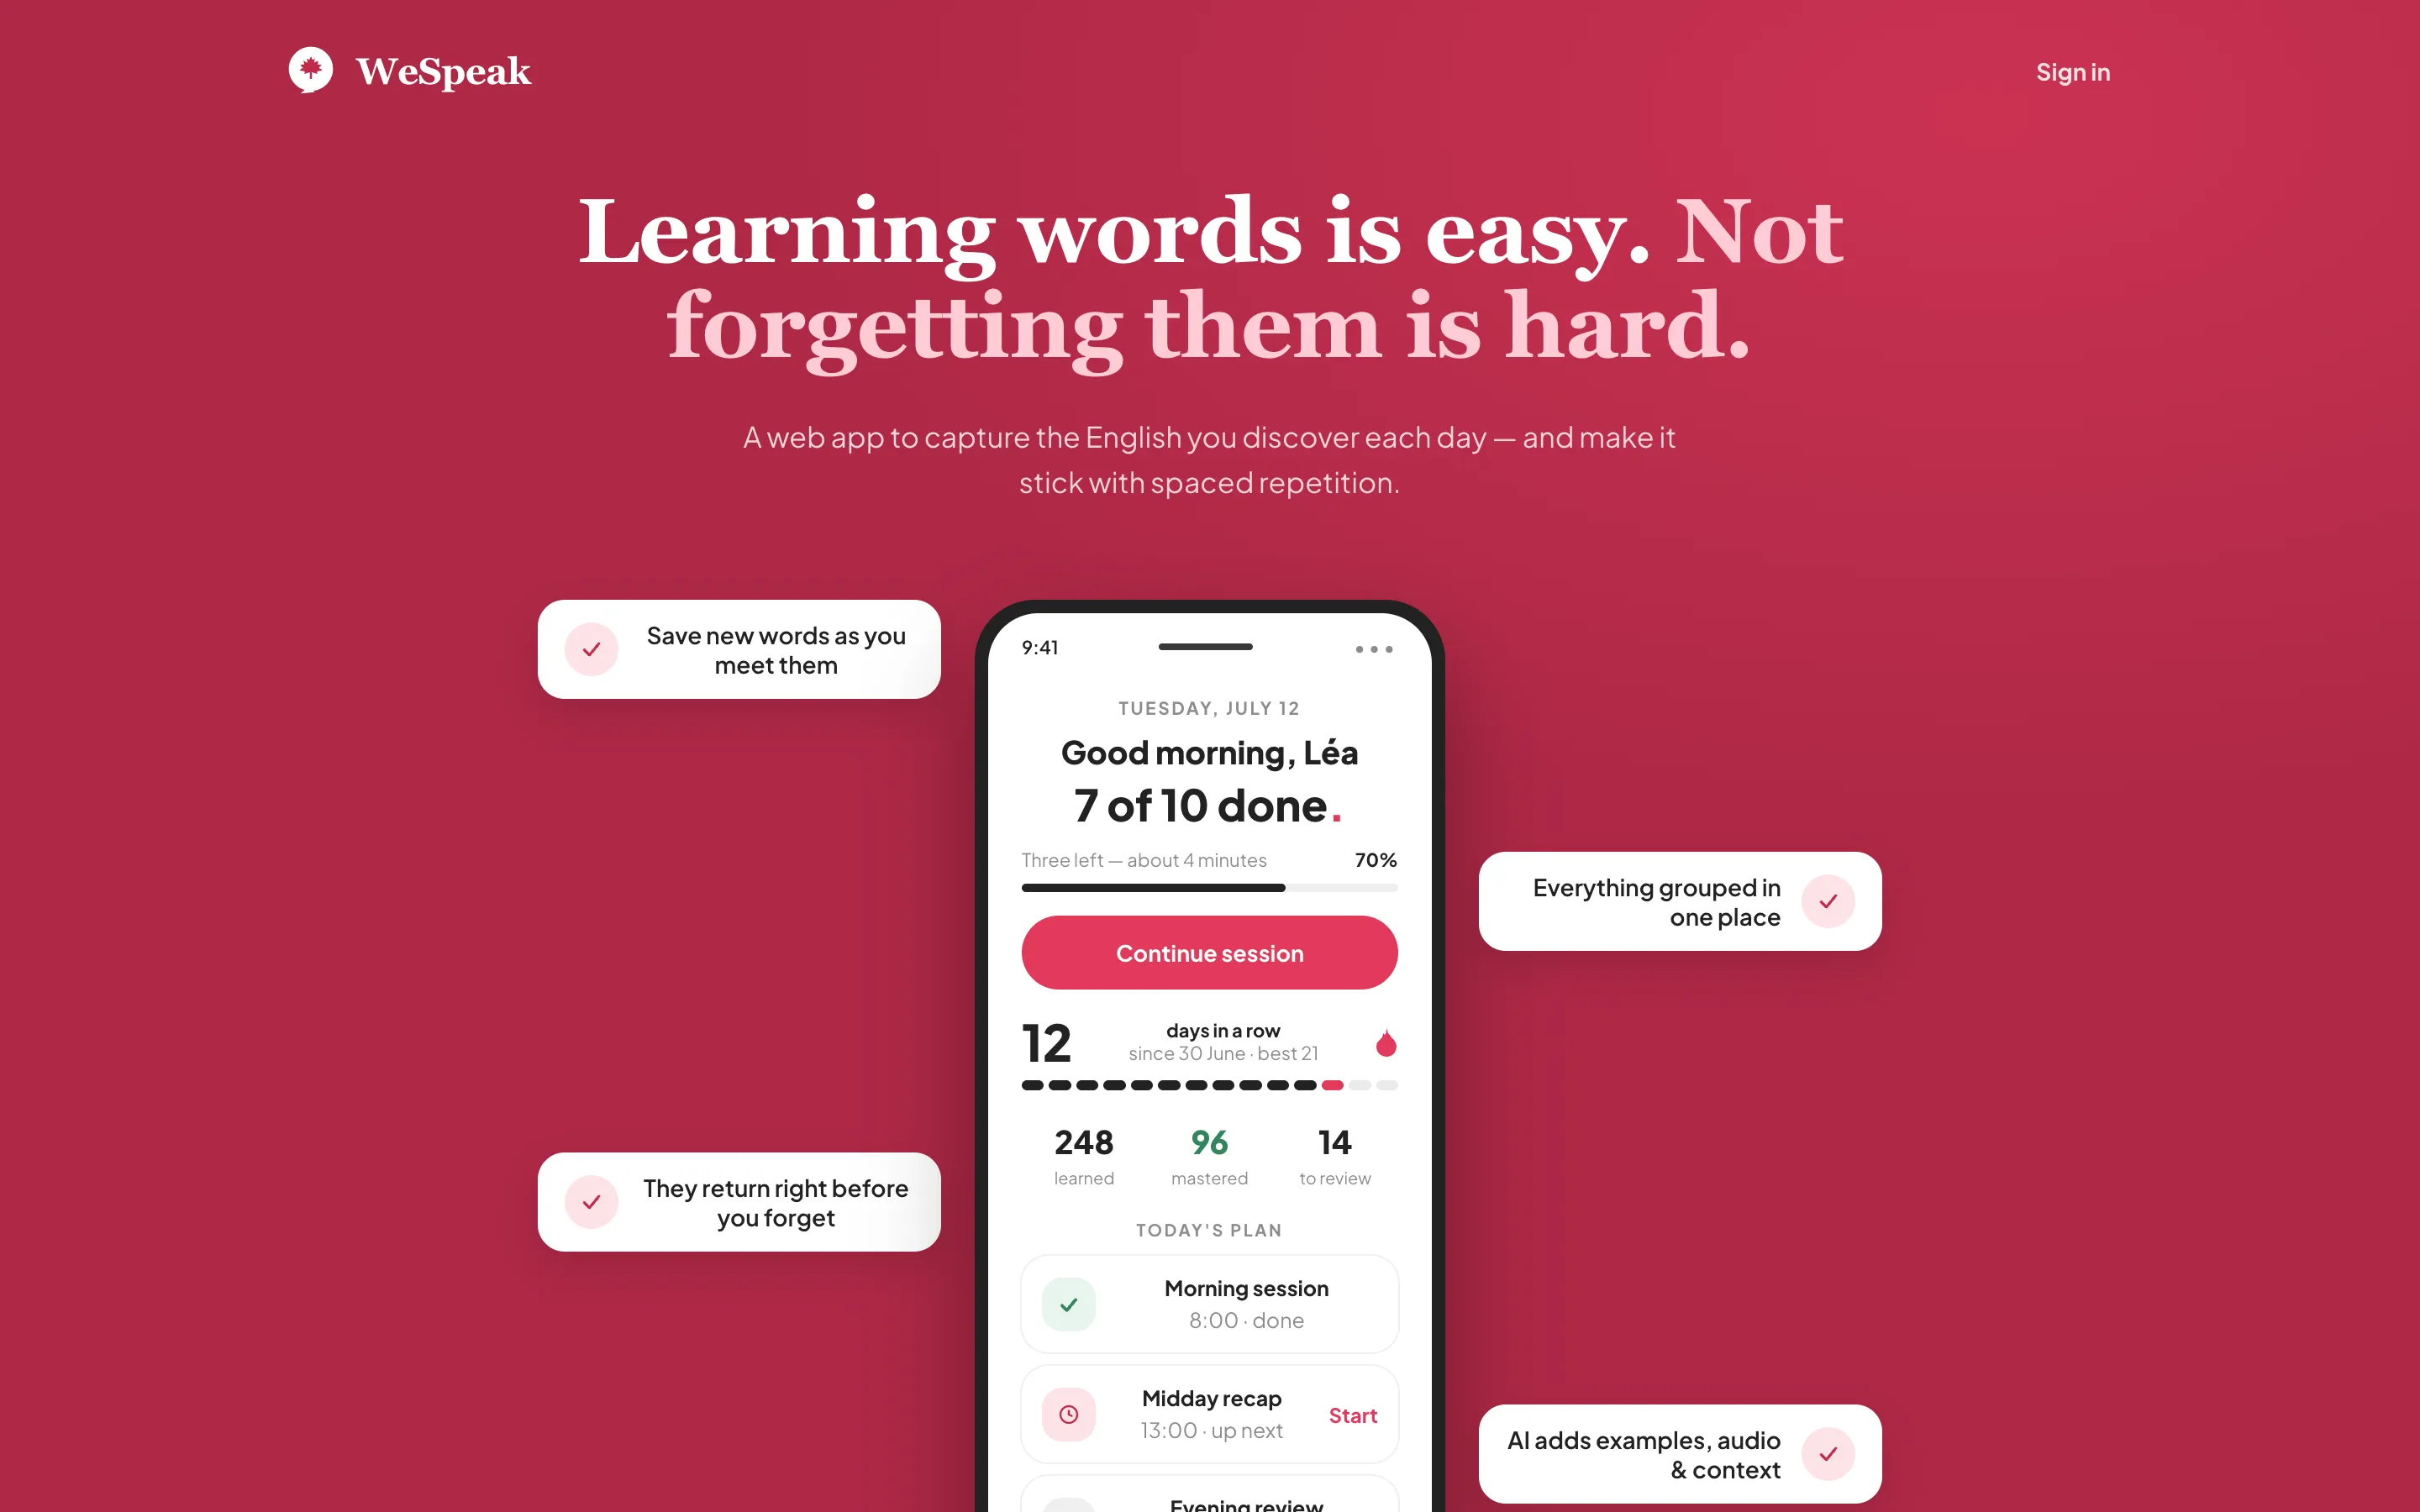
Le problème
Aucune application de vocabulaire que j’ai essayée ne correspondait à ma façon d’apprendre : noter les mots que je croise vraiment dans ma journée, puis les revoir juste avant de les oublier.
Ce que j’ai construit
- La répétition espacée avec l’algorithme SM-2, pour que chaque mot revienne au bon moment.
- Du contenu généré par LLM (exemples, audio et contexte), enrichi par une tâche planifiée GitHub Actions.
- Supabase pour l’authentification et PostgreSQL, sur un schéma SQL que j’ai conçu.
- Un serveur Node/Express facultatif pour les appels d’IA côté serveur.
- Une documentation d’architecture sous forme de carte interactive du code, en HTML.
- Une exploration de la génération augmentée par récupération (RAG).
Mon rôle
Je l’ai conçu et construit de bout en bout : décisions produit, modèle de données, interface, chaîne d’enrichissement par l’IA et déploiement.
La suite
- Des exercices sur les temps de verbes.
- Des applications iOS et Android construites avec Capacitor.