Initiative personnelle chez FedEx, à Chicoutimi, approuvée et appuyée par mon gestionnaire
Parcel Vision
L'agent photographie le colis ; les données arrivent dans le tableur du sous-traitant. Conçu chez FedEx, où trois agents retapaient à la main environ 300 colis par jour.
−89 %de saisie manuelle par jour, de ~3 h à ~20 min
- Rôle
- Créateur. Cadrage du problème, développement, évaluation, déploiement et formation des utilisateurs
- Période
- 2025 – 2026
- Statut
- En production
- Technologies
- Python
- Streamlit
- API Claude Vision
- Qwen2.5-VL + LoRA
- EasyOCR
- PostgreSQL
- Docker
- Caddy
- VPS
Liens
Demander une démoL'application en production est protégée par mot de passe. Je vous la présente volontiers en direct.
Le problème
Chez FedEx à Chicoutimi, trois agents retapaient les données d’environ 300 colis par jour dans les tableaux exigés par nos sous-traitants : nom, adresse, code postal, poids et dimensions. Près de trois heures de saisie manuelle chaque jour, avec les erreurs de frappe qui vont avec.
Ce que j’ai construit
Une application Web pensée autour d’un seul geste : l’agent photographie le colis.
- Un modèle de vision lit l’étiquette imprimée ainsi que les dimensions et le poids notés à la main, puis extrait le numéro de suivi, le destinataire, l’adresse, le code postal, les dimensions et le poids.
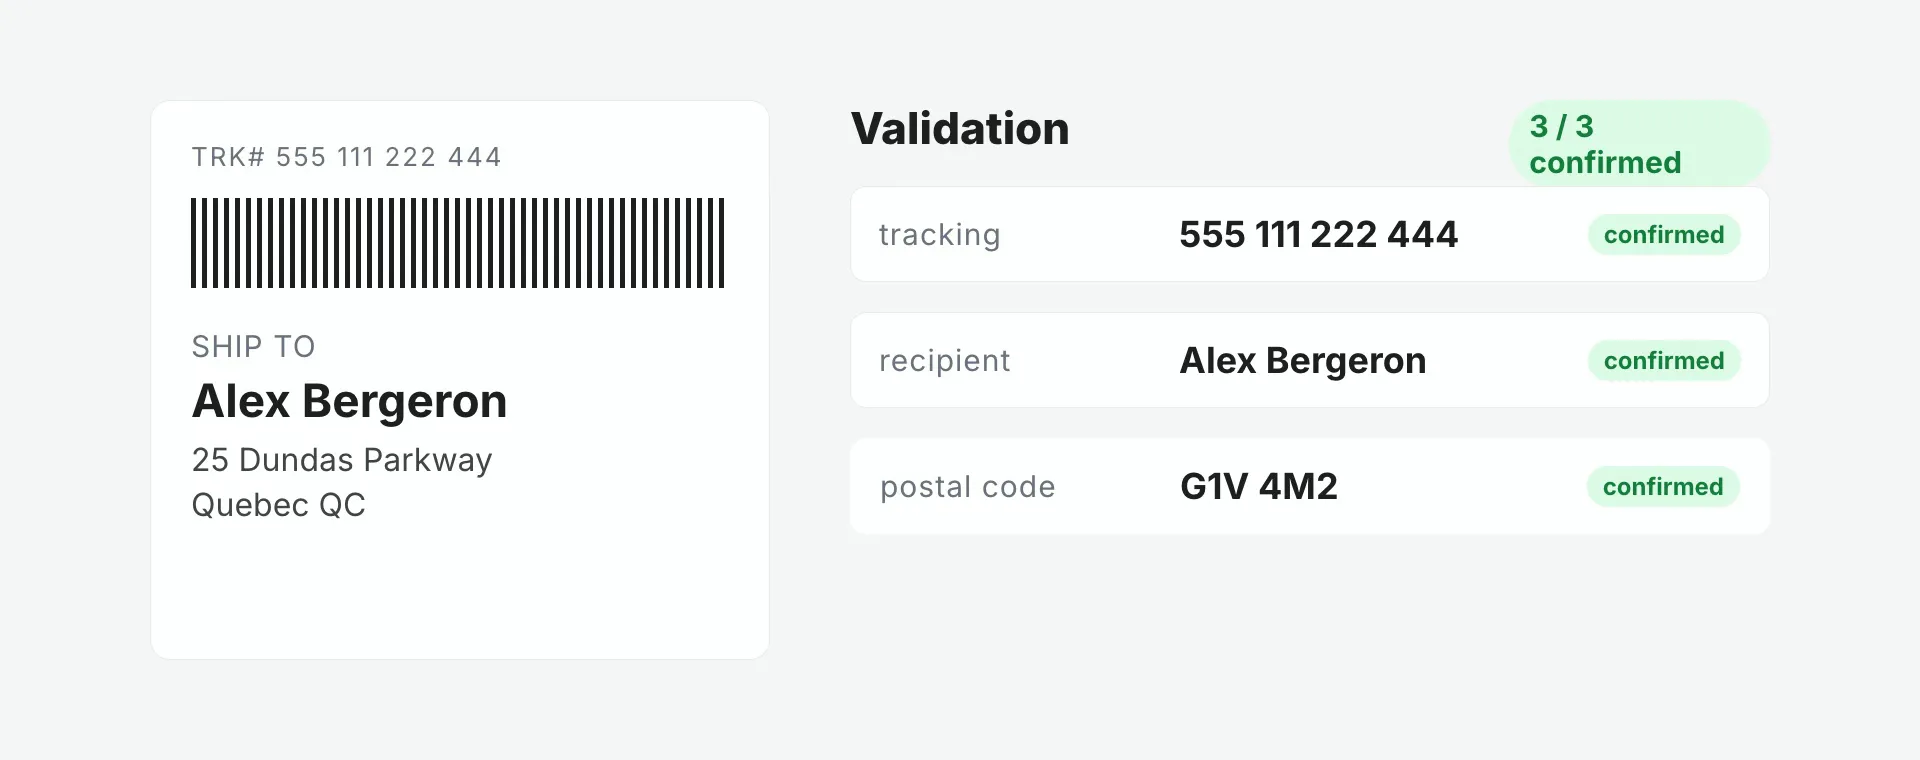
- Un écran de validation affiche la photo à côté des champs extraits. L’agent confirme ou corrige chacun d’eux : rien ne part sans vérification humaine.
- Un clic exporte le lot vers Excel, exactement au format attendu par les sous-traitants.
- Trois méthodes d’extraction interchangeables : l’API Claude Vision en production, un modèle Qwen2.5-VL que j’ai affiné avec LoRA, et un OCR gratuit en solution de repli.
Comment j’ai choisi le modèle
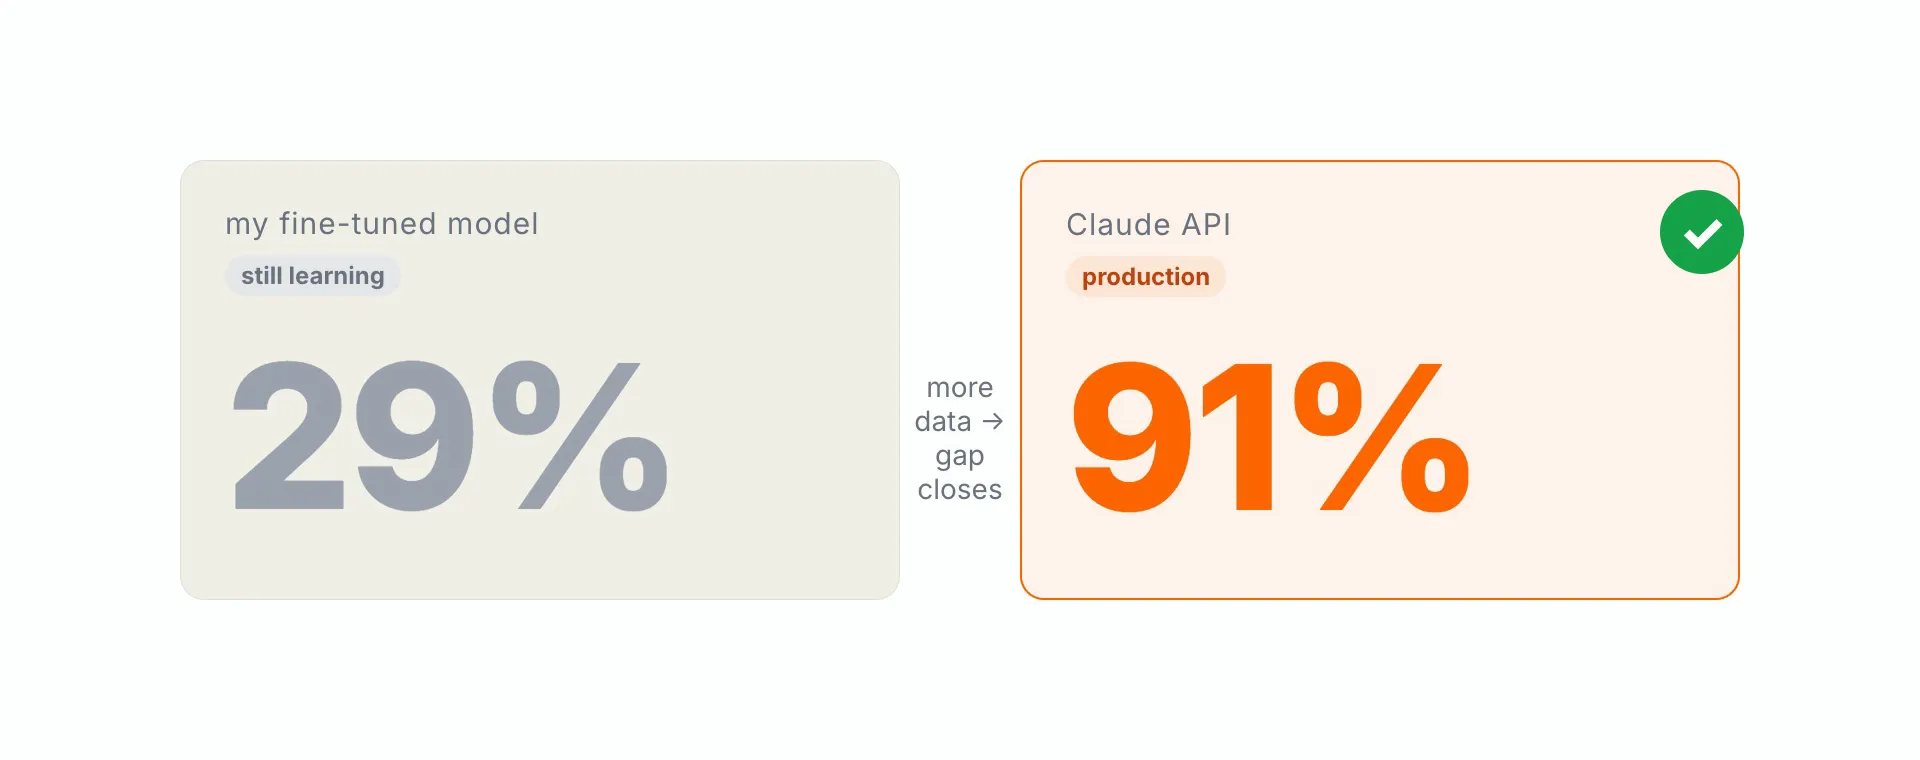
J’ai mesuré avant de choisir. Sur 69 étiquettes réelles, l’API Claude Vision atteint 91 % de précision par champ ; mon Qwen2.5-VL affiné, 29 %. Claude assure l’extraction en production, et mon Qwen2.5-VL affiné apprend de ses résultats pour combler l’écart.
Mon rôle
J’ai repéré le problème sur le plancher et je l’ai présenté à mon gestionnaire, qui a approuvé le projet et l’a appuyé. J’ai conçu l’interface, la chaîne d’extraction et le banc d’évaluation, déployé l’application avec Docker sur un VPS en HTTPS, puis formé les agents.
Résultat
- Saisie manuelle quotidienne passée de ~3 h à ~20 min, soit 89 % de moins.
- Erreurs de transcription éliminées.
- Meilleur suivi des colis.
Visuels
- PhotoL'agent photographie l'étiquette du colis.
- ExtractionAPI Claude Vision en production, avec un Qwen2.5-VL affiné et un OCR de repli.
- VérificationL'agent confirme ou corrige chaque champ.
- Export ExcelEn un clic, au format des sous-traitants.
Application Streamlit · historique PostgreSQL · Docker sur un VPS · HTTPS avec Caddy